Nucleo di Ilum
L'idea dei processi Spark interattivi è quella di offrire a un utente la possibilità di eseguire processi Spark consecutivi senza un lungo tempo di inizializzazione dell'applicazione Spark.
Ilum è progettato per portare la potenza di Apache Spark negli ambienti Kubernetes, sfruttando il meglio di entrambi gli ecosistemi. Fondamentalmente, mira a semplificare il processo di distribuzione, gestione e monitoraggio dei processi Spark, indipendentemente dal gestore cluster sottostante.
L'idea dei processi Spark interattivi è quella di offrire a un utente la possibilità di eseguire processi Spark consecutivi senza un lungo tempo di inizializzazione dell'applicazione Spark.
Ilum si integra con Kubernetes per automatizzare la gestione dei cluster, semplificando l'implementazione in ambienti nativi per il cloud.

Si integra perfettamente con i cluster Kubernetes, dove vengono eseguiti i processi Spark.
Ilum è progettato per portare la potenza di Apache Spark negli ambienti Kubernetes, sfruttando il meglio di entrambi gli ecosistemi. Fondamentalmente, mira a semplificare il processo di distribuzione, gestione e monitoraggio dei processi Spark, indipendentemente dal gestore cluster sottostante.
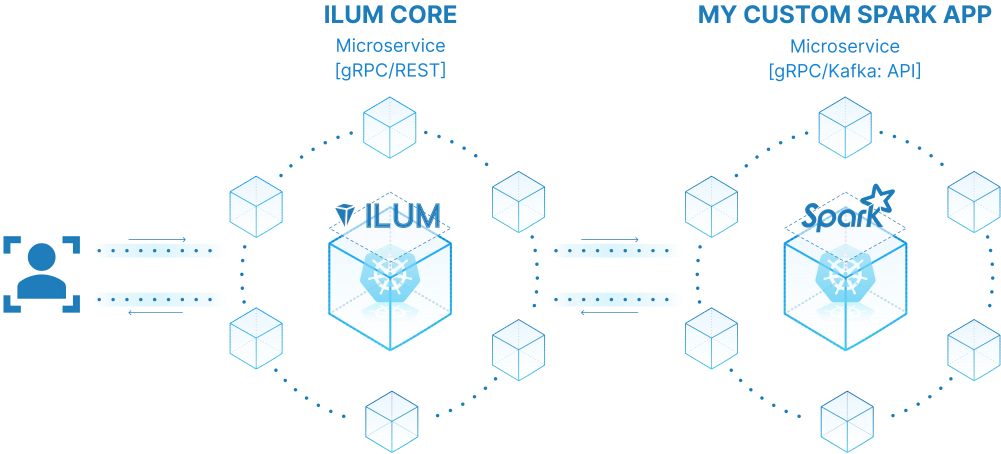
La parte centrale dell'architettura Ilum è l'ilum-core, che è responsabile della creazione, della gestione e del monitoraggio dei processi Spark. Espone le API REST (conformi allo standard OpenAPI 3.0) con cui i client possono interagire ed è responsabile della pianificazione e dell'esecuzione dei processi Spark nei cluster Kubernetes connessi.
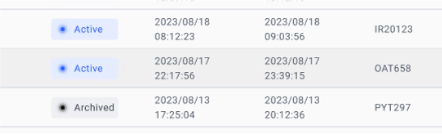

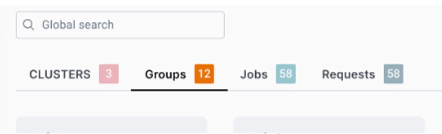
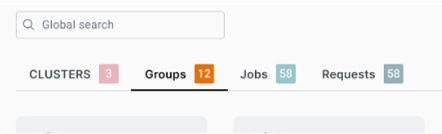
Si tratta di un'interfaccia Web intuitiva che consente agli utenti di gestire e monitorare i processi Spark. Comunica con l'ilum-core tramite le API REST.
Per gli utenti con sistemi legacy, Ilum supporta completamente anche Apache Hadoop Yarn, offrendo flessibilità sia nelle infrastrutture moderne che in quelle tradizionali.

Ilum si integra con varie soluzioni di archiviazione di oggetti, fornendo un'alternativa all'HDFS di Hadoop. Ciò consente di archiviare e recuperare grandi volumi di dati in modo distribuito e scalabile.
Ilum utilizza MongoDB come database interno per l'archiviazione dei metadati dei processi, delle informazioni sul cluster e di altri dati operativi.
Kafka può essere utilizzato come livello di comunicazione in Ilum per lo streaming e l'elaborazione dei dati affidabili ed efficienti
Apprezziamo il tuo feedback e siamo sempre desiderosi di migliorare. Se hai suggerimenti che potrebbero migliorare la tua esperienza o semplificare la navigazione del prodotto, faccelo sapere. Unisciti a noi per plasmare il futuro della nostra piattaforma! Il tuo contributo è importante.
Aggiungere una richiesta di funzionalità